Series
创建
多种方式创建,列表,字典,从其他Series中截取均可
可以传入的参数有:要存储的元素,索引,元素类型,名字等等
arr=pd.Series({"a":1,"b":2,"c":3})
arr=pd.Series([1,2,3],index=['a','b','c'])
arr=pd.Series([1,2,3],index=['a','b','c'],name="月份")
arr=pd.Series([1,2,3],dtype=float,name="月份",index=['a','b','c'])
属性:
values:获得Series中所有值
shape:获取Series的维度,几行几列
dtype:获取Series中数据的数据类型
ndim:获取维度
size:获取元素个数
name:获取名字
属性
print(arr)
print(arr.values)
print(arr.shape)
print(arr.dtype)
print(arr.ndim)
print(arr.size)
print(arr.name)
访问索引以及切片:
分为显式和隐式
print(arr.loc['a':'c'])#通过key来获取值
print(arr.loc['a'])

print(arr.iloc[0:3])#隐式索引,通过默认索引来获取值
print(arr.iloc[0])

#只能访问单个元素
print(arr.at['a'])
print(arr.iat[0])#隐式索引
Series也支持布尔索引:print(arr[arr<3])
方法:
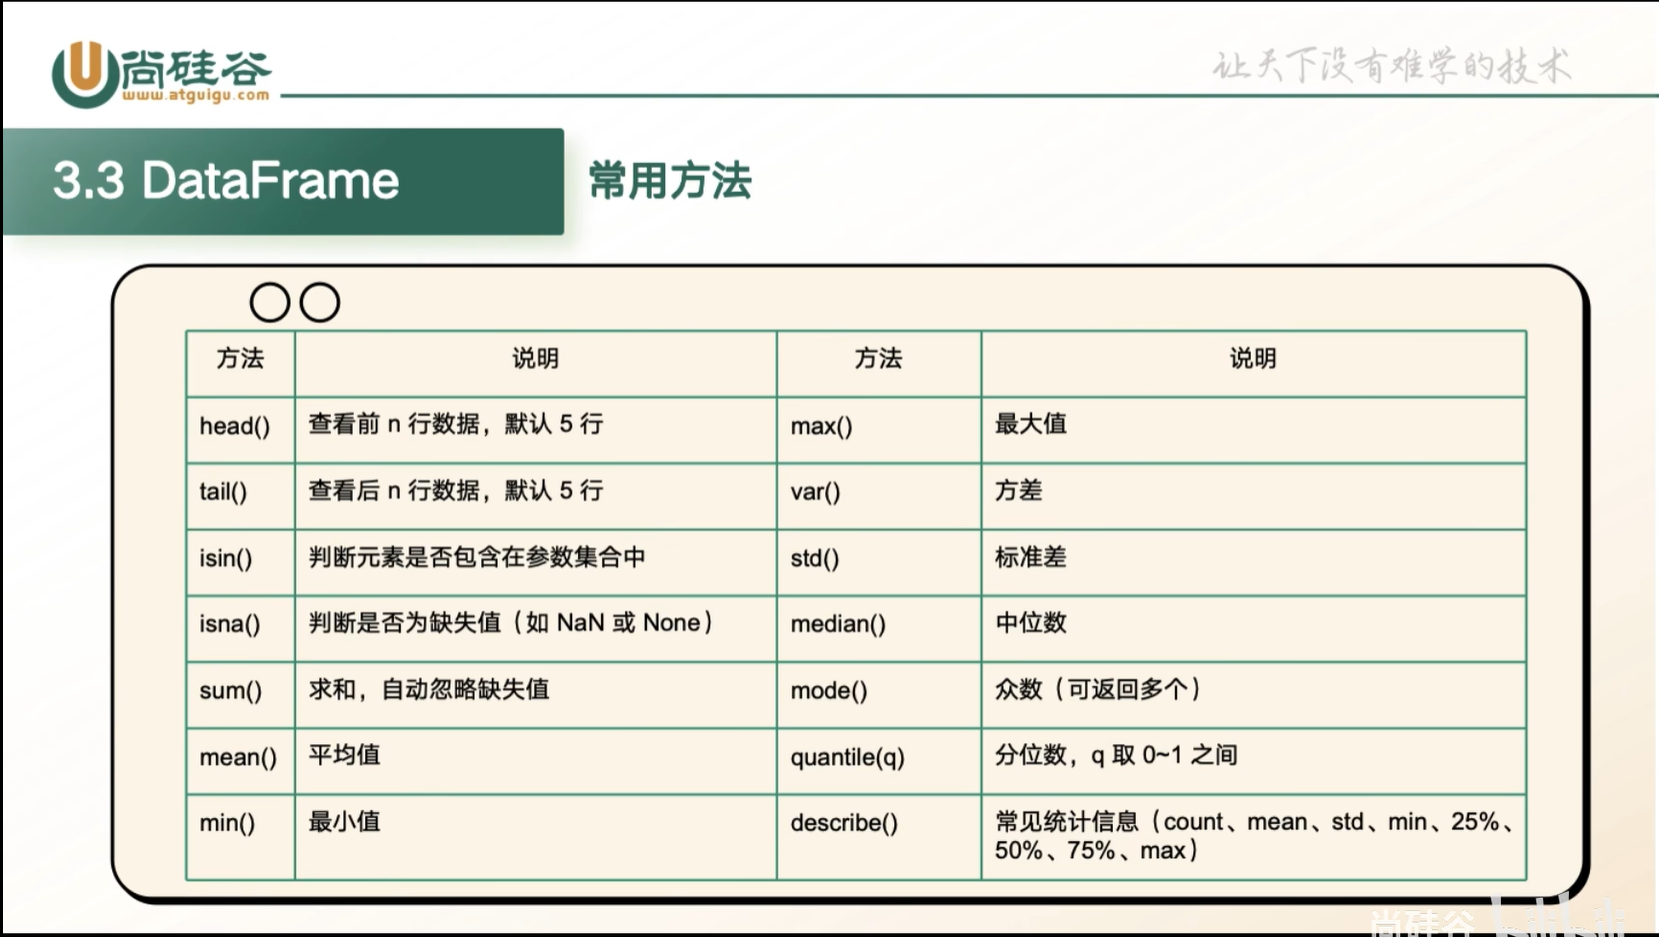
head方法和tail方法从开头或者结尾取出部分元素
print(arr.head())# 默认返回前5行,内部填入数字表示开头几行
print(arr.tail())# 默认返回最后5行,内部填入数字表示结尾几行
展示基础属性:describe()
1,不包含缺失值的情况下有多少数
2,平均值
3,标准差
4,25%,50%,75%分位数
5,最小值,最大值
获取元素个数,不包含缺失值:count()
获取索引:arr.index,arr.keys()
检测缺失值s.isna(),s.isnull()
检测不是缺失值s.notna()
检测数据是否在Series中:s.isin()
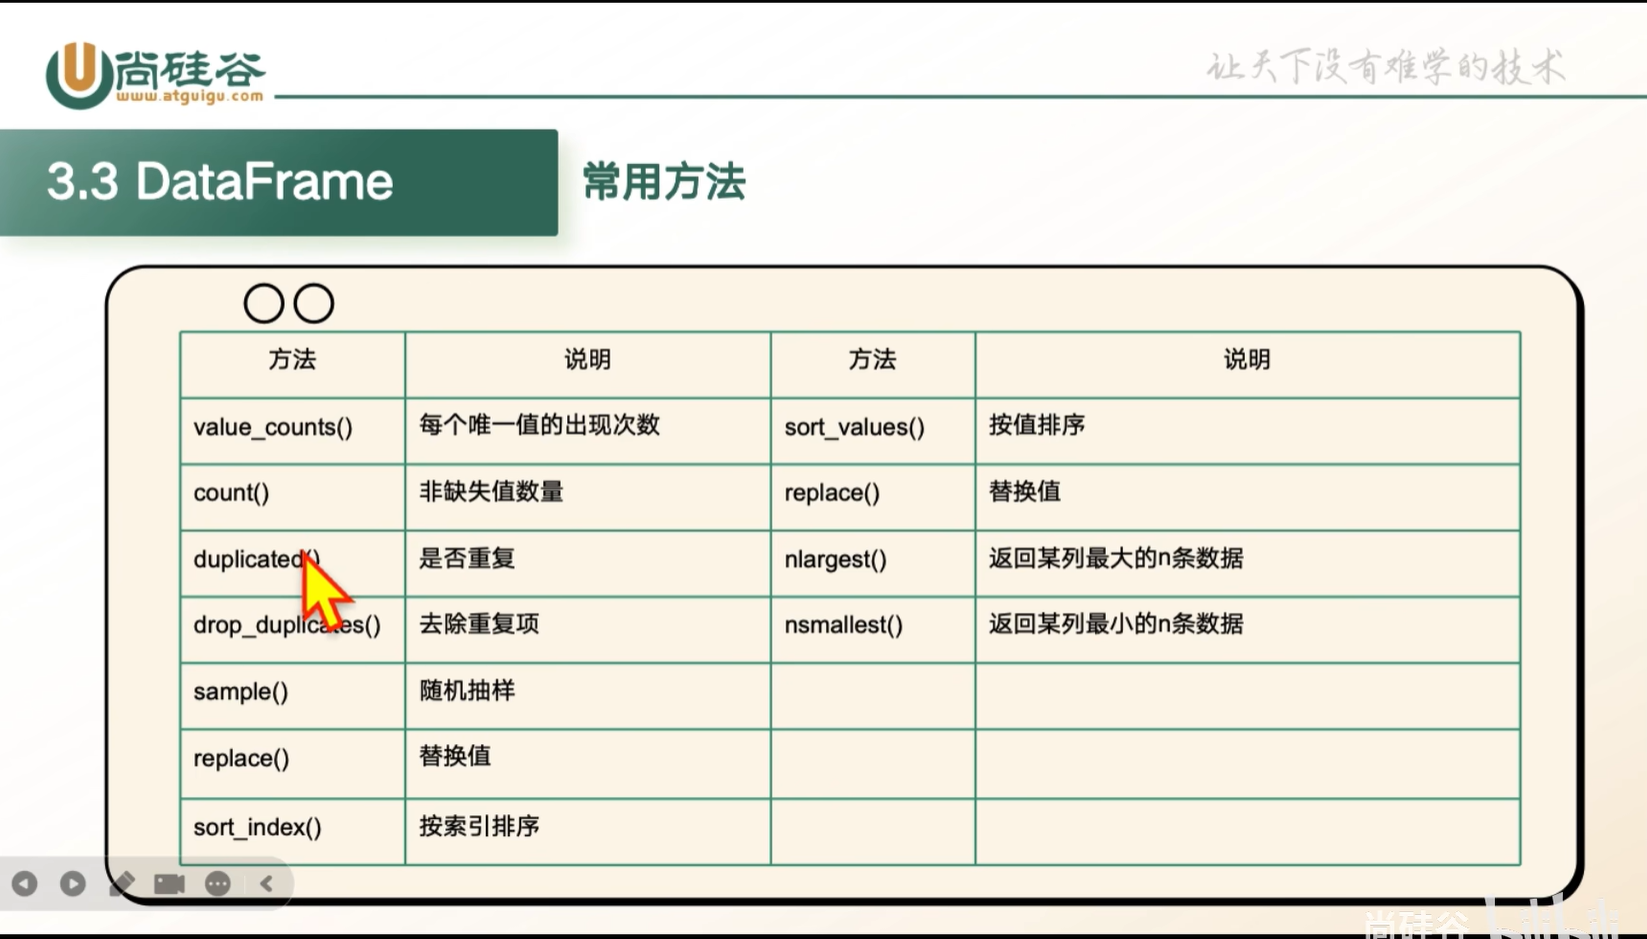
排序,从小到大排s.sort_values(),从大到小排:s.sort_values(ascending=False)
Series其中也有算中位数,分位数,最大值,最小值,平均数的方法,和numpy类似
DataFrame
创建:
通过字典创建,通过Series创建,通过ndarray创建
s1=pd.Series([1,2,3])
s2=pd.Series([4,5,6])
df=pd.DataFrame([s1,s2],index=['1','2'])
df2=pd.DataFrame(
    {
        '第一列':['J','Q','K'],
        '第二列':["A","2","3"]
    },index=[1,2,3],columns=['第二列','第二列']
)
注意!#值得注意的是,如果将columns中的第一列和第二列改名为其他名字,这并不会将这两列进行重命名,反而会导致错误
如上述columns中均为”第二列‘,那么输出的结果是两行第二列而并非将第一列的名字改为了“第二列”,要改名请在创建DataFrame中进行改名,这里的原因是df2为字典创建,而字典的键不可改变
属性:
绝大部分都与Series一样
方法:
绝大部分和Series一样